IAIA aplicada MX
 BR
En México entrenan con una firma brasileña una IA para las lenguas indígenas
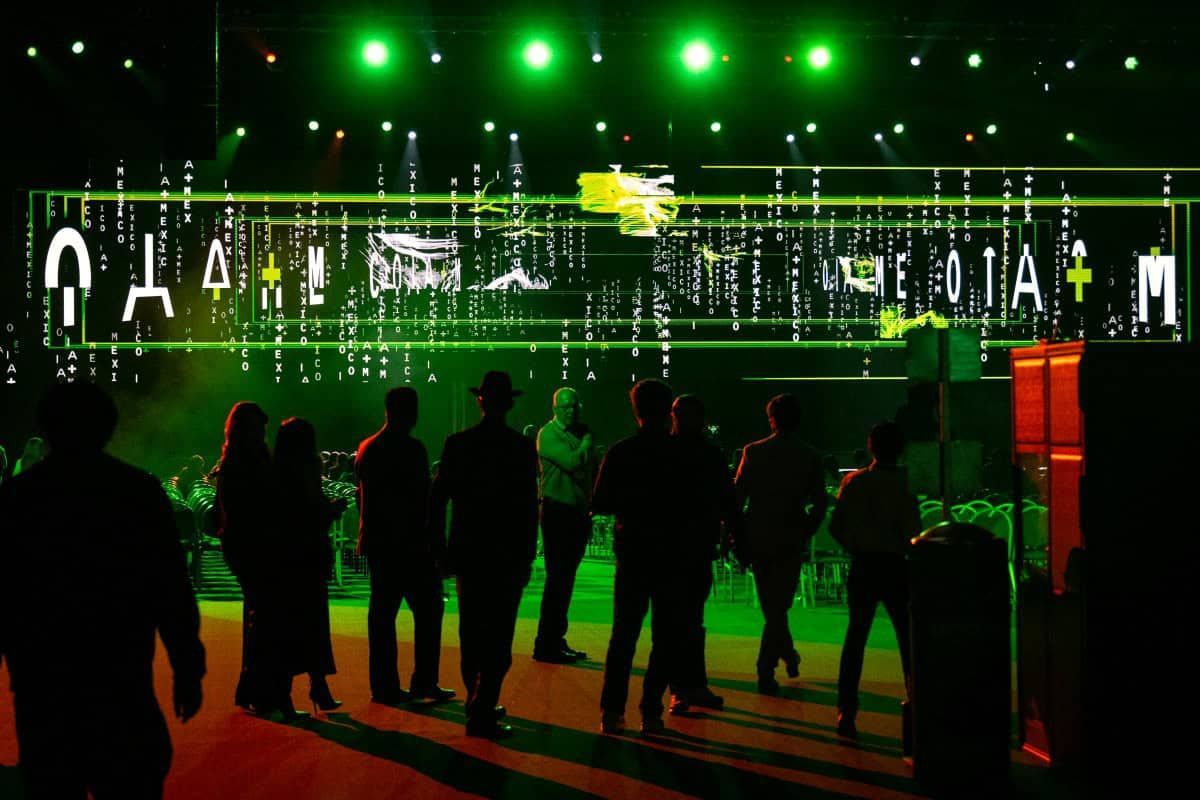
Monarca Lab y la brasileña WideLabs esperan tenerlo listo en un año, pero no dijeron qué lenguas cubrirá, con cuántos datos ni quién lo financia.
Monarca Lab, la firma de inteligencia artificial que fundó Jessica Peña, y la brasileña WideLabs entrenan un modelo de lenguaje pensado para las lenguas indígenas de México, contó Peña a la agencia AFP. El país tiene unas 68 lenguas indígenas, y sus hablantes suelen vivir en localidades pobres y con poco acceso a la tecnología.
"Lo que estamos buscando es que no queden de lado las comunidades", dijo Peña. El modelo todavía está en entrenamiento y sus creadores esperan tener resultados en un año. El anuncio se hizo en México IA+, un encuentro del sector en Ciudad de México, y AFP lo difundió el 6 de noviembre.
Primero el español, después las lenguas originarias
Las dos versiones que circulan no describen igual el punto de partida. AFP habla de un modelo entrenado "a partir de idiomas indígenas". Imagen Radio, que cubrió el 5 de noviembre el lanzamiento de Hub IA+, la iniciativa que agrupa el proyecto, dio otro orden. Según ese medio, el modelo, que todavía no tiene nombre, se construye por ahora con datos en español disponibles en el país, y las lenguas indígenas se sumarán dentro de seis meses. La meta es que en aproximadamente un año lo puedan usar empresas en casos reales.
Ninguna de las dos fuentes precisó qué lenguas entrarán primero, con cuántos datos se entrena el modelo, quién lo paga ni si será de uso abierto. Tampoco cómo participarán las comunidades hablantes.
Peña, que además preside el consejo de México IA+, explicó el proyecto en clave de soberanía tecnológicaCapacidad de un país de decidir sobre la tecnología que usa, desarrolla y regula, sin depender por completo de proveedores o gobiernos extranjeros.. "Que paremos un poco el tener esta dependencia extranjera y que pasemos a ser productores nosotros", dijo a Imagen Radio. Hub IA+ arranca con nodos en cuatro estados, Ciudad de México, Querétaro, Guanajuato y Puebla, y apuesta a llegar a nueve. El gobierno de Claudia Sheinbaum busca impulsar la IA como parte del Plan México, que apunta a sustituir importaciones en medio de los choques comerciales con Estados Unidos, recordó AFP.
El antecedente brasileño
WideLabs llega con un modelo similar en portugués, que tiene en cuenta las variantes del idioma en Brasil y que instituciones públicas de justicia de ese país usan para orientar a los ciudadanos, según AFP. Un caso publicado por NVIDIA describe uno de esos usos. En el Ministerio Público de Rio Grande do Sul, WideLabs montó una plataforma con agentes de IASistema de inteligencia artificial que actúa de forma autónoma para cumplir una tarea, por ejemplo usando programas o conectándose a internet, sin intervención humana en cada paso. para fiscales y un asistente de atención pensado para víctimas, personas de bajos ingresos y con poca educación formal. Según NVIDIA, funciona desde enero de 2025 y alcanza a más de ocho millones de personas en los 497 municipios del estado.
Pasar de una lengua con cientos de millones de hablantes a decenas de lenguas con pocos textos digitalizados es otro problema. Los grandes modelos de lenguaje (LLM)grandes modelos de lenguaje (LLM) Modelos de inteligencia artificial entrenados con enormes cantidades de texto para comprender y generar lenguaje; son la base de asistentes conversacionales y herramientas de IA generativa. aprenden de lo que encuentran escrito, y en lenguas indígenas eso es poco.
Lo que dicen las pruebas en la región
Un estudio de BID Lab, Microsoft y LLYC, el laboratorio de innovación del Banco Interamericano de Desarrollo, midió cómo responden los principales modelos en quechua, guaraní, aimara, náhuatl y maya quiché. El quechua sacó 3,72 puntos sobre 10 y el maya quiché, 1,25, frente a 8,58 del catalán. Más de un tercio de las preguntas hechas en lenguas indígenas recibió la respuesta en otro idioma. El mismo trabajo encontró que la calidad sigue de cerca la cantidad de datos abiertosDatos que gobiernos u organizaciones publican en formatos reutilizables y con permiso para que cualquiera los use, los analice o los combine. en cada lengua, con el número de artículos de Wikipedia como mejor indicador.
Según ese informe, que cita a la UNESCO, menos del 2 % del contenido de internet está en lenguas indígenas, y casi cuatro de cada diez de las 556 lenguas originarias de América Latina y el Caribe están en riesgo de desaparecer. En Paraguay, el proyecto GuaranIA, que cofinancia BID Lab, armó un corpusColección ordenada de textos, grabaciones y transcripciones de una lengua que se usa para estudiarla o para entrenar programas de inteligencia artificial. Cuanto más grande y variado es el corpus, mejor aprende el modelo esa lengua. del guaraní validado con las comunidades hablantes para entrenar asistentes de salud, educación y servicios financieros.
El modelo de Monarca Lab y WideLabs tendrá que resolver ese mismo cuello de botella. La primera prueba llegará en seis meses, cuando, según el plan contado a Imagen Radio, entren las lenguas indígenas.
Glosario
soberanía tecnológica
Capacidad de un país de decidir sobre la tecnología que usa, desarrolla y regula, sin depender por completo de proveedores o gobiernos extranjeros.
Glosario
agentes de IA
Sistema de inteligencia artificial que actúa de forma autónoma para cumplir una tarea, por ejemplo usando programas o conectándose a internet, sin intervención humana en cada paso.
Glosario
grandes modelos de lenguaje (LLM)
Modelos de inteligencia artificial entrenados con enormes cantidades de texto para comprender y generar lenguaje; son la base de asistentes conversacionales y herramientas de IA generativa.
Glosario
datos abiertos
Datos que gobiernos u organizaciones publican en formatos reutilizables y con permiso para que cualquiera los use, los analice o los combine.
Glosario
corpus lingüístico
Colección ordenada de textos, grabaciones y transcripciones de una lengua que se usa para estudiarla o para entrenar programas de inteligencia artificial. Cuanto más grande y variado es el corpus, mejor aprende el modelo esa lengua.
Yahoo Finance
Entrenan en México un modelo de lenguaje con IA a partir de idiomas indígenas
Firmas de inteligencia artificial entrenan un modelo de lenguaje a partir de idiomas indígenas hablados en México, anunciaron este viernes los desarrolladores a cargo del proyecto.El anuncio ocurrió…
Imagen Radio 90.5
México puede ser un gran centro de desarrollo de inteligencia artificia: lanzan Hub IA+
México tiene el potencial de convertirse en jugador clave en el desarrollo de inteligencia artificial, por eso la iniciativa privada, gobierno y academia se...
NVIDIA Customer Stories
Widelabs AI Makes Legal Services More Accessible for Millions in Brazil
Read this customer story and more.
IDB Lab
IA que habla lenguas originarias: la clave para cerrar la brecha lingüística de la economía digital en América Latina
Contexto (5 términos)
- soberanía tecnológica
- Capacidad de un país de decidir sobre la tecnología que usa, desarrolla y regula, sin depender por completo de proveedores o gobiernos extranjeros.
- agentes de IA
- Sistema de inteligencia artificial que actúa de forma autónoma para cumplir una tarea, por ejemplo usando programas o conectándose a internet, sin intervención humana en cada paso.
- grandes modelos de lenguaje (LLM)
- Modelos de inteligencia artificial entrenados con enormes cantidades de texto para comprender y generar lenguaje; son la base de asistentes conversacionales y herramientas de IA generativa.
- datos abiertos
- Datos que gobiernos u organizaciones publican en formatos reutilizables y con permiso para que cualquiera los use, los analice o los combine.
- corpus lingüístico
- Colección ordenada de textos, grabaciones y transcripciones de una lengua que se usa para estudiarla o para entrenar programas de inteligencia artificial. Cuanto más grande y variado es el corpus, mejor aprende el modelo esa lengua.
Fuentes
- Entrenan en México un modelo de lenguaje con IA a partir de idiomas indígenas (AFP vía Yahoo Finanzas, 2026-11-06)
- México puede ser un gran centro de desarrollo de inteligencia artificial: lanzan Hub IA+ (Imagen Radio, 2026-11-05)
- Widelabs AI Makes Legal Services More Accessible for Millions in Brazil (NVIDIA, 2026-01-14)
- IA que habla lenguas originarias: la clave para cerrar la brecha lingüística de la economía digital en América Latina (BID Lab, 2026-09-11)